搜索到
39
篇与
的结果
-
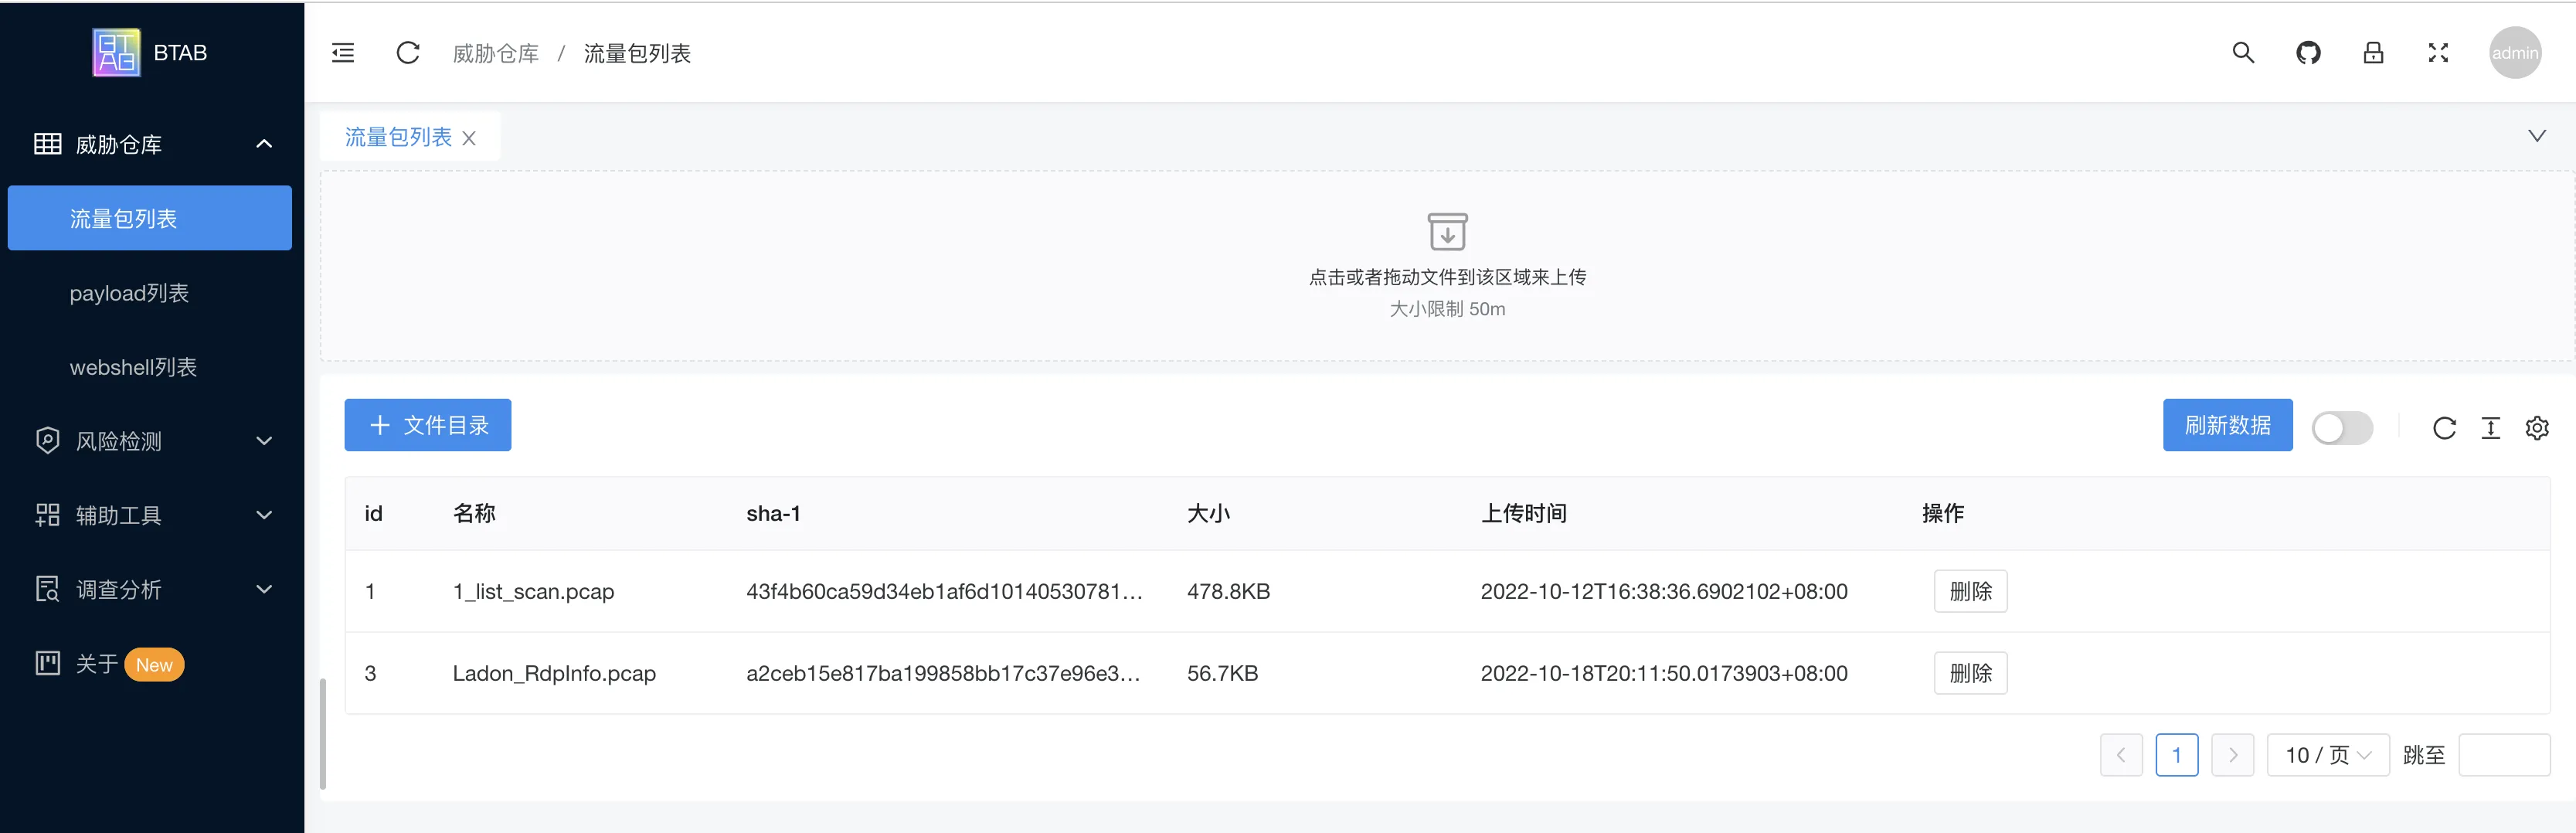
 BTAB蓝队分析箱-技术拆解 BTAB 蓝队分析工具箱干过蓝队研判的人大概都有一套肌肉记忆:拿到一个 pcap,先 tshark -r 拉一遍字段,字段多了加 -Y 过滤,输出的东西想再筛一层就接 jq,jq 表达式写错一个点就得重敲;如果拉到的是 base64 或者序列化数据,还得切到别的工具去解;最后把可疑 payload 复制出来,粘到另一处做检测。一条流程下来命令敲了七八条,中间结果全在终端里滚过去了。想回溯某一步的中间态,只能重新跑一遍。问题不在于工具不够,而在于每一步都是孤岛。tshark 只管拆包,jq 只管切 JSON,检测引擎只管给结论。人就是中间那个传输管道,还得自己维护上下文。BTAB(Blue Team Analysis Box)做的事情很直接:把这些步骤定义成一条可以书写的管道,让上一级的输出自动喂给下一级。作者是 Martin2877(ID:Ali0th),仓库在 https://github.com/Martin2877/btab,Apache-2.0 协议。项目基本盘项目情况仓库地址Github.com/Martin2877/btab作者Martin2877 / Ali0th开源协议Apache License 2.0创建时间2022 年 11 月最后代码提交2024 年 7 月当前 Star96技术栈Go(gin) + Vue(nAIve ui) + Python(gRPC / Jupyter) + Java默认端口8001(gRPC 50051 / WebSocket 5003)仓库标签pcap-analyzer、webshell、http-analysis、detection、chatgpt、golang先把话说明白:这不是一个还在高频迭代的项目。代码停在 2024 年 7 月,Star 数不到三位数,在 GitHub 上属于"小而冷"的那一档。但它值得拆,因为架构设计有想法。DSL 管道 + 统一插件接口 + Jupyter 外挂,这套组合在国产开源蓝队工具里不多见。很多商业流量分析产品的静态查询语句本质是同一套逻辑,只是没开源出来。还有个细节挺有意思——仓库标签里挂着一个 chatgpt。README 的路线图里写着 v0.6.x 要做的事情是:"结合 AI 实现分析,用户复制 payload 到 btab 上,然后拆解并组成问题,然后你黏贴到 GPT 上进行分析"。在 2024 年这个思路算是走得挺前的,现在回头看主要是败在了没有 API 化,靠人肉复制粘贴,效率上不来。四大功能模块启动后访问 http://localhost:8001,左侧菜单就是它的全部能力,分四块。一、威胁仓库三张表:流量包列表、payload 列表、webshell 列表。说白了就是素材池——把待分析的 pcap、可疑 payload、webshell 文件先丢进去存着,后面的检测和查询都从这里取。这个设计挺实用。研判很多时候不是线性的,一个 pcap 里扒出来的 payload 可能过两天才想起来要复检;webshell 样本攒多了也需要一个地方放。有统一的入库动作,比散在桌面某个文件夹里靠名字找强。配图 1:威胁仓库的流量包列表二、风险检测核心模块,六个检测项:菜单说明流量包检测走 pcap 分析引擎,检测结果落库成表HTTP 深度解析请求 / 响应拆解,含 UA 类型识别风险详情检测项的明细视图SQLi 检测注入特征识别XSS 检测跨站脚本特征识别Webshell 检测文件内容特征识别bash 命令检测命令执行行为识别前端表格直接带出 pcap 文件名、来源、检测类型、检测结果、检测时间,一屏看完不用来回切。配图 2:风险检测结果列表三、辅助工具六个工具页:tshark:在页面里直接调 tshark 做字段提取jq:JSON 处理SerializationDumper:Java 反序列化数据解析(原项目是 Java 实现,这里用 go embed 内嵌)BlueTeamTools(ABC_123):内嵌的第三方工具集CyberChef、Regex101:经典工具,内嵌页面配图 3:辅助工具里的 jq内嵌 CyberChef 和 Regex101 这个做法,作者在 README 里也坦白过,是为了"零依赖、开箱可用"。从工程角度看有点偷懒(iframe 嵌外部页面),但对使用者来说确实省了切标签页和记 URL 的力气。四、调查分析整个项目最有前瞻性的一块:用 Jupyter Notebook 做威胁狩猎。查询管道适合固定套路,但真实研判里有很多"没有固定套路"的分析——时序分析、频次统计、聚类、机器学习模型调用。这些用查询语言表达不了,必须上代码。BTAB 的做法是开一个 gRPC 服务(:50051),用 Python 客户端连上去,在 Jupyter 里写脚本调它的引擎。配图 4:Jupyter 中的 log4j 批量检测上图是仓库自带的 S2_Log4j检测_beta.ipynb,遍历 payload 逐个检测 log4j 漏洞,最后打印命中的 payload。这种"脚本驱动批量检测"的用法,比在页面上一个个点效率高得多。装起来:三个依赖和一个端口下载 release,配好 config.yaml 就能启动。完整配置长这样:dbConfig: enabledefault: false sqlite: btab.sqlite logConfig: compress: false max_age: 365 max_backups: 1 max_size: 50 serverConfig: jwt_secret: btab run_mode: release open_browser: true # 启动时自动打开浏览器 engineConfig: webshell_host: "http://localhost:8080" pcapanalyse_host: "http://localhost:5000" bash_host: "http://localhost:8899" grpcConfig: address: :50051 websocketConfig: address: :5003 pcapAnalyseConfig: # tsharkPath: tshark # unix、mac 下使用 tsharkPath: C:\Program Files\Wireshark\tshark.exe # win 下使用三个依赖,按需装:tshark(必装):pcapAnalyseConfig.tsharkPath 必须指向真实的 tshark 路径。Windows 下装 Wireshark 时如果没勾选命令行工具,这个路径根本不存在。Linux / macOS 下直接写 tshark 就行,前提是它在 PATH 里。Java 环境(可选):反序列化解析功能需要。Jupyter 依赖(可选):要用调查分析才装。pip install jupyterlab pip install grpcio-tools启动方式就是双击执行文件,起来后访问 8001 端口。数据库默认用 SQLite,单文件 btab.sqlite,也支持切 MySQL——配置里 mysql 那几行注释掉的部分就是。核心设计一:DSL 管道这是 BTAB 最有想法的地方,值得展开。基本语法它设计了一套自己的查询语言,规则很简单:| 开头的行表示指定一个引擎|: 开头的行表示指定引擎的一个变量: 开头的行表示定义全局变量连续的 | / |: 行组成一节管道最基础的一条,用 pcap 引擎读包:| pcap |: file log4j_test.pcap |: fields ["ip.src", "tcp.srcport", "ip.dst", "tcp.dstport", "text"] |: condition http这三行参数最终等价于这么一条 tshark 命令:tshark -r log4j_test.pcap -Y "http" -T fields -e ip.src -e tcp.srcport -e ip.dst -e tcp.dstport -e text参数都可以省,只写 file 就用默认的 fields 和 condition。省事,但也就意味着拿不到你想要的字段精度——真做分析还是老实把 fields 写全。串联:内联引用真正解决问题的是跨节引用。用 {{R}} 指代上一节的结果,把 pcap 和 jq 串起来:// 拉取数据 | pcap |: file log4j_test.pcap |: fields ["ip.src", "tcp.srcport", "ip.dst", "tcp.dstport", "text"] |: condition http // 针对上一步结果做处理 | jq |: filter .[0] | .text[-1:] |: content {{R}}第一步拿包里符合 http 条件的报文,第二步用 jq 表达式切出最后一个元素,结果自动进下一步。注意 // 是注释,解析器会把以 - 或注释开头的行跳过。多流管道:这套 DSL 的差异点单流管道(上一步输出给下一步)在很多产品里都有,Splunk 的 SPL、Sentinel 的 KQL 本质都是这类思路。BTAB 在这里做了一次升级——从单流升级到多流。意思是管道里的每一步不必只能吃上一步的输出,可以任取前面任意一步的结果,也可以引用自定义的全局变量。: a ' union select concat(md5(2001427499))# : b { "foo": { "bar": { "baz": 123 } } , "boo":"123"} : c { "foo": { "bar": { "baz": "' union select concat(md5(2001427499))#" } } , "boo":"123"} | jq |: filter .foo.bar |: content {{c}} | jq |: filter .foo.bar |: content {{b}} | jq |: filter .baz |: content {{R[0]}} | sqli |: content {{R}}: 定义全局变量,{{c}} 引用变量 c,{{R[0]}} 引用第 1 步的结果,{{R}} 引用上一步。上面这段的执行顺序是:定义三个全局变量 a、b、c用 jq 处理变量 c,取出 { "baz": "' union select concat(md5(2001427499))#" }用 jq 处理变量 b,取出 { "baz": 123 }用 {{R[0]}} 拿第 2 步的结果再取 .baz,得到 ' union select concat(md5(2001427499))#把结果喂给 sqli 引擎,检出注入单流管道只能顺着走一条线,多流管道可以分叉、可以回头取中间态。做复杂载荷构造时差别很明显——你可以在一条查询里同时准备"输入报文"和"应答报文"做交叉比对,不用来回倒腾。配图 5:单流管道模型(每一步的输出即下一步的输入)配图 6:多流管道模型(可任取历史节点结果,形成分叉)完整示例:从 pcap 到 SQLi 判定把三步串成一条流,这是最能说明问题的例子:// 拉取数据 | pcap |: file sqlinjection_9.pcap |: fields ["http.request.uri"] |: condition http // 处理 json 获取 uri | jq |: filter .[].["http.request.uri"][0] |: content {{R}} // 调用 sql 注入检测引擎 | sqli |: content {{R}}拆包 → 提取 URI → 送检测引擎。这就是文章开头说的"把工具串起来"。也可以直接调检测引擎,不带前置管道:| sqli |: content ' union select concat(md5(2001427499))#核心设计二:插件接口管道里能调用的每个东西,在代码里都是一个插件。BTAB 用 Go interface 定了统一规格:type Plugin interface { Init() // 初始化 Set(key string, value interface{}) // 设置插件所需变量 Check() error // 检查设置变量值 Exec() error // 执行此插件 GetState() int // 获取插件任务进度 GetFinalStatus() int // 获取最终结果状态 GetResult() string // 获取输出结果 }七个方法,职责划得很干净:Init 清空状态Set 接收 DSL 里 |: 传进来的参数Check 校验参数,比如文件名为空直接报错,不往下走Exec 真正干活GetState / GetFinalStatus 汇报进度和结果状态,给前端做状态展示GetResult 吐结果,喂给下一节管道注册方式是一个全局 map:var PluginMap = make(map[string]Plugin) func init() { PluginMap["jq"] = &jq.JQ{} PluginMap["SerializationDumper"] = &SerializationDumper.SerializationDumper{} PluginMap["pcap"] = &pcap.Pcap{} }新增一个插件就是实现这七个方法,然后往 map 里补一行。引擎侧启动时会遍历 PluginMap,自动把插件名注册成可用的引擎关键字,不用改 DSL 解析逻辑:func init() { for p := range plugin.PluginMap { PluginEngines = append(PluginEngines, p) } }这个设计的好处是语法和具体能力解耦。加一个"URL 解码"插件,语法层面零改动。README 里写的"理论上能力可以无限扩展",前提就是这个接口稳得住。看一个具体实现,pcap 插件的参数处理:func (plugin *Pcap) Set(key string, value interface{}) { switch key { case "file": plugin.File = value.(string) case "fields": fieldsSource := fmt.Sprintf(`{"fields": %s}`, value.(string)) fields := gjson.Get(fieldsSource, "fields") for _, v := range fields.Array() { plugin.Fields = append(plugin.Fields, v.String()) } case "condition": plugin.Condition = value.(string) } }fields 从 DSL 传进来是一个 JSON 数组字符串,这里借 gjson 解析成 Go 切片再用。所以 DSL 里写 fields ["ip.src", "tcp.srcport"] 合法,写 fields ip.src 就会解析失败——这是上手时容易踩的小坑。校验逻辑也简单直接,缺参数就掐掉:func (plugin *Pcap) Check() error { if plugin.File == "" { return errors.New("参数检查不通过, file 为空") } return nil }核心设计三:Jupyter 调查分析查询语言解决的是"有套路"的分析,"没套路"的要靠脚本。BTAB 通过 gRPC 把引擎能力开放给 Python。仓库 investigation/ 目录下有个 btab.py,是封装好的客户端:import grpc import rpc.btab_pb2 as btab__pb2 import rpc.btab_pb2_grpc as btab_pb2__grpc address = 'localhost:50051' channel = grpc.insecure_channel(address) class Search: def __init__(self) -> None: self.stub = search_pb2__grpc.SearchStub(channel) def Submit(self, content): response = self.stub.Submit(search__pb2.SubmitRequest(content=content)) return response.message class Engines: def __init__(self) -> None: self.stub = engines_pb2__grpc.EnginesStub(channel) def CheckAlive(self): response = self.stub.CheckAlive(engines__pb2.CheckAliveRequest()) return response.message def Run(self, content): response = self.stub.Run(engines__pb2.RunRequest(content=content)) return response.message在 Jupyter 里用起来是这样:import json from btab import BTAB, Engines, Search # 初始化并检查连通性 btabIns = BTAB() if btabIns.Ping().Type == "success": print("连接成功") # 检查所有可用引擎 eg = Engines() if eg.CheckAlive().Type == "success": print("检查完成") # 提交一条查询 search = Search() content = """ // 拉取数据 | pcap |: file log4j_test.pcap |: fields ["ip.src", "tcp.srcport", "ip.dst", "tcp.dstport","text"] |: condition http """ result1 = search.Submit(content) results = json.loads(result1.Result) len(results)注意这里可以在 Python 里直接写 DSL 字符串提交——页面上的查询能力和脚本里的查询能力是同一套,不存在"界面能做、API 不能做"的落差。返回的 Result 是 JSON 字符串,json.loads 之后就是正常的 Python 对象,后面接 pandas、numpy、matplotlib 随你。仓库里给了两个实验性的例子:S7_ssh慢速连接_beta 用 matplotlib 做时序可视化,SX_webshell文件机器学习检测_beta 加载训练好的模型做检测:from machinelearning.WebshellMLChecker import WebshellMLChecker wc = WebshellMLChecker() ret = wc.process(body["request_body"]) print("检测结果:", ret)从"查"到"建模",这条路是通的。虽然都标着 beta,但方向是对的——研判做到深处一定会撞上需要统计和模型的地方,工具能不能承接住这一步,比它内置了多少条规则重要。一个容易被忽略的前提:外部引擎依赖这条得单独拎出来说,因为它直接决定你能不能跑通。看后端的引擎分层:目录内容依赖backend/engine/local/sqli、XSS、http_parseGo 原生实现,离线可用backend/engine/online/pcapanalyse、bashHTTP 调外部服务backend/engine/plugin/jq、pcap、SerializationDumper本地插件问题出在 online 这一类。pcapanalyse 的地址是硬编码默认值加配置覆盖:const Address = "http://127.0.0.1:5000" func NewPA() *PA { address := Address if conf.GlobalConfig.EngineConfig.PcapAnalyseHost != "" { address = conf.GlobalConfig.EngineConfig.PcapAnalyseHost } return &PA{Address: address} }而风险检测里的"流量包检测",调的就是这个引擎。也就是说:只下载 release 包、只装了 tshark,流量包检测这一项是跑不出结果的——它需要一个监听在 localhost:5000 的 pcap 分析服务,而这个 Python 服务在开源仓库里没有。同理bash_host指向localhost:8899,BASh命令的检测同样需要对应外部的服务。作者于 README 中对开源范畴的阐释颇为直白:最多仅能部分进行开源,由于涉及商业方面的问题,企业内部部分核心的检测项不便于开源;但是部分非敏感功能模块能够开源成为独立项目以供学习借鉴。因此对BTAB的合理预期得划分成两个档次:能够直接使用的威胁仓库素材管理,辅助工具tshark,jq,反序列化分析以及 CyberChef,调查分析 Jupyter 和 gRPC,SQLi还有XSS在本地进行检测。需要自己去补充服务:流量包的检测,bash命令的检查。这并非是项目的事情,而是作者的选择。但是如果按照“已集成的流量包进行检测”此类话就去部署生产机会被踩空。拿它当什么用说点实际的判定。BTAB的精准定位是个人分析的工作平台,并非是生产级别的检测工具。它不是像Suricata那样的旁路流量IDS,也没有进行阻断。其价值体现在“人机配合”这一方面:将分析师的拆包,筛字段,切JSON,送检测等机械操作固化成可重复使用的查询话语,把需要进行思考的部分留存到Jupyter里面的脚本里面。能力界限对着瞧:适合用于pcap事后研判,payload批量复检,webshell样本归档,把日常的tshark命令转化成可以重复使用的查询方面的语句。不适用于实时进行流量检测,横向拓展到多机开展分布式解析,需要厂商层级规则库来支撑的情况。技术选择是比较务实的:Go保障了单文件分发的方便情况(前端使用 Go - bindata - assetfs 打包进入二进制,只需要拷贝文件就可以操作),Python担负起分析层,科学计算的生态没有办法被替代,Java只是用来啃取反序列化的数据, gobed 内嵌调用,不需要单独开展服务。在 backend/engine/ 目录当中非测试的GO文件仅仅有16个,并且插件的实现也是非常薄弱的。这意味如果仅仅去学习架构的话,阅读的成本是较低的— —“插件接口加上DSL管道加上多流引用”这三个方面,自己从头开始设计一整套查询的语言,多数会走很多弯路,在这里有现成的参照。要是你仅仅想要一个可以进行蓝队分析的环境,fig. yaml 去配置tshark的路径就可以开始工作;要是想要完整的功能,得先去确认那么几个外部的服务你是否有。
-
AI-Infra-Guard-腾讯朱雀开源AI红队平台 近期,不管是公司这一方面还是个人那一块,都如同着了魔一般地去构建AI应用。在本地进行Ollama的部署来运行DeepSeek,运用ComfyUI来开展绘图工作,利用vLLM来作为推理服务,在Dify以及Coze上进行拖拖拽拽的操作来搭建工作流,MCP Server也承接了不少相关事务。我周边搞开发的朋友,十个当中有八个在做这些个事情。但很少有人问一句:你搭的这些东西,安全吗?今年2月份朱雀实验室发过一个预警,说很多人本地部署的Ollama、DeepSeek这些开源AI工具,都带着默认配置漏洞,公网一开攻击者直接就能拿服务器。问题是知道有问题又能怎么样?总不能自己对着CVE列表一个个去核对吧?腾讯朱雀实验室将他们自身所使用的AI红队平台予以开源,此平台被称作AI-Infra-Guard,简称为A.I.G。该项目还成功入选了Black Hat Europe 2025 Arsenal。GitHub:https://github.com/Tencent/AI-Infra-Guard直白来讲,这个玩意儿就是专门用来给AI系统做安全方面检查的。以前是用Nessus去扫描服务器的漏洞,用Nmap去扫描端口,而A.I.G扫描的是AI的基础设施。它可不是那种写几个正则来匹配CVE编号的简单脚本,它从底层的模型服务,到中间的Agent工作流,再到上层的MCP插件,一层一层地给你进行检测。腾讯安全平台部于2019年成立了朱雀实验室。朱雀实验室曾经协助NVIDIA、Google、微软等厂商以及OpenClaw、Hugging Face等开源社区发掘了相当多的高危漏洞。朱雀实验室在Black Hat、DEF CON等会议上发表过论文,并且还出版过《AI安全:技术与实践》这一本书籍。朱雀实验室并非是那种去蹭AI热度的草台性质的项目。在GitHub上面存在着四千多颗星。更新的情况还算是比较频繁的。到了2026年6月份的时候还在连续地发布版本。来瞧瞧用户的列表吧,腾讯它自己、DeepSeek、工行、招行、vivo、OPPO、B站,就连蜜雪冰城都在进行使用。目前A.I.G集成了五个主要功能,基本把AI系统能出问题的地方都覆盖了:AI 基础设施漏洞扫描属于基础的功能。它可以对 100多种 AI 组件的指纹进行识别,能够匹配 1900多个 已知的 CVE。像 vLLM、Ollama、llama.cpp 这类推理引擎,Gradio、LangChain、Streamlit 这类开发框架,ComfyUI、n8n、Dify、Coze 这类应用平台,还有 ClickHouse 这类组件都可以被它识别到。在使用的时候输入 IP 或者域名,它自己进行识别版本、匹配漏洞库,之后直接就告诉你哪个组件存在什么漏洞、严重程度是如何、该怎么进行修复。接下来对于MCP Server和Agent Skill进行安全扫描。MCP当下已经成为AI Agent生态的实际标准,但是同时也是新的攻击重点区域。A.I.G可以检测14大类MCP安全风险,其中包含指令劫持、记忆投毒,还有远程代码执行、权限提升、依赖投毒这类常见问题。无论是扫描源码还是扫描远程URL都可以,不需要运行服务就能够检测。存在一个多Agent自动化红队扫描框架。此框架是专门用于对Agent工作流的安全性进行测试的。Dify以及Coze上运行着的Agent都能够接入进来进行测试。它会自动去查找越权、数据泄露、工具滥用这类相关的问题。如同给你的Agent免费聘请了一个红队来进行检查一样。大模型有关于越狱评估的相关状况。它内部内置了好几组越狱测试数据集。它会运用各种各样的方式去尝试突破你的模型。它还能够支持多个模型来进行横向的对比,直接就可以告知你哪一个模型更加难以被越狱。要是你去运用OpenClaw生态系统,直接安装“aig-scanner”这一功能模块便能够一键进行扫描操作,而无需单独地去部署整个平台体系 。界面是现代化Web UI,支持中文。Docker一键部署,4G内存、10G磁盘就能跑:在左侧的菜单当中去点击相对应的功能,然后填入目标地址便能够开始进行扫描,进度将会实时地进行显示,最终会生成可视化的报告,在这个报告里面有漏洞的详细情况、风险的等级评定、修复的相关建议,并且还可以进行导出操作。部署方式有三种,最快的是用预构建Docker镜像:Git clone https://github.com/Tencent/AI-Infra-Guard.git cd AI-Infra-Guard Docker-compose -f Docker-compose.images.yml up -d懒人的话直接用一键脚本:curl https://raw.githubusercontent.com/Tencent/AI-Infra-Guard/refs/heads/main/docker.sh | bash对该文章进行如下较为随意且存在表述问题的改写:访问了网址为http://localhost:8088的网站。默认的账号和密码那就是admin以及admin。进入到里面之后,得要记住去修改密码。如果只是想快速扫单个目标,不用部署Web服务,直接下二进制文件命令行跑就行:# 单个目标 ./ai-infra-guard -target http://127.0.0.1:11434 # 扫多个 ./ai-infra-guard -target 192.168.1.100 -target example.com # 加AI分析,让混元大模型给你出修复建议 ./ai-infra-guard -target http://127.0.0.1:8000 -ai -token your-token做CI/CD集成的话,还有个 aig-skill-scan 的Python包,pip装完就能在流水线里跑Skill安全审计:pip install aig-skill-scan export LLM_API_KEY="your-api-key" aig-skill-scan --repo /path/to/skill -m deepseek-v4-flash -o result.json我为什么推荐这个项目?首先来讲讲靠谱这回事。腾讯朱雀实验室所搞的这个东西,在Black Hat上面登台讲过,而且是大厂都在使用的,可不是那种个人开发者随随便便弄来玩玩的项目。再就是真的很全面,从底层的CVE到上层的MCP风险,还有Agent安全以及越狱测试,把AI安全的主要方面全都涵盖进去,不用你东拼西凑好几个工具。更新的速度还很快,我看到6月份还在更新,刚刚又加了39个新的AI组件指纹、600多条CVE规则,这样的项目才敢用在生产环境当中。首先得是好用的。WebUI操作比较简单,点那么几下就可以进行扫描。界面是中文的,不用你去编写一大堆的配置文件。有完整的API,还能够当作Skill直接安装到Agent里面去,对于DevSecOps是挺友好的。它是遵循Apache 2.0协议开源的,商业方面使用也没有问题,还可以自己添加规则插件。当下人工智能安全的情形确实有些可笑。所有人都急切地将人工智能往生产环境中推进,全然没有人去关注安全这件事情。这如同在2000年初的时候大家疯狂地建设网站,没有人去管SQL注入、XSS这些问题是一样的情况。等到出现了被拖库、被挖矿、数据泄露这些状况才想着去进行补救,到那个时候就已经晚了。不要等到出现问题了才去采取行动。花上三分钟的时间来对A.I.G进行设置,对您所运行着的很多人工智能应用做一番检查,这并没有什么不妥的地方。注:禁止对未授权的目标进行渗透测试GitHub地址:https://github.com/Tencent/AI-Infra-Guard
-
DeathStar:域渗透自动化利用工具 前言DeathStar是一款域渗透自动化工具。它依托于BloodHound数据以及Empire C2框架。当获取到一个普通域用户权限之后,DeathStar能够自动地利用BloodHound所找到的攻击路径。随后通过Empire自动地去开展提权、横向移动这类操作。最终能够获取Domain Admin到Enterprise Admin权限,将手动一步步的域渗透转化成为全自动的流程。核心功能全自动域提权拿到初始立足点后(只要有一个Empire agent),不需要手动输命令,DeathStar自动:运行BloodHound侦察收集域数据分析最短域管路径自动执行提权、凭据dump、横向移动拿到域管权限后结束整个的这个进程全部都是处于自动的状态。它如同蠕虫一般一步接着一步地去获取那最高的权限。异步架构0.2.0这个版本已经完完全全地进行了重新书写。它是依托于AsyncIO异步架构的。那么它的速度相较于原来的那个版本可是快上不少。而且还可以支持同时在好多台机器上面去开展操作。多林/多域支持有这样一种较为复杂的活动目录(AD)环境存在着,在这个环境之中是支持有多个域以及多个林的情况的。能够跨越域信任关系去发起攻击行为,然后从而获取企业管理员(Enterprise Admin)的权限。实时监控Active Monitoring这个功能会持续地不间断地去检查所有处于被管控状态的机器。一旦察觉到有新登录的具有高权限的用户,就立刻借助这个用户,然后自动地对攻击的路径进行调整。Kyber Crystal插件系统运用插件架构(`Kyber Crystals),每一个人都可以去进行编写插件来对功能进行扩展,并且还可以对Empire`的所有模块予以支持。Empire 4.x支持存在这么一个基于BC - Security进行维护的Empire的分叉版本,此版本是可以兼容最新的Empire相关功能的。工作原理DeathStar自动化执行常见域渗透TTP:初始侦察:在当前agent上运行BloodHound/SharpHound收集域数据本地提权:尝试本地提权漏洞拿到系统权限凭据dump:dump LSASS内存,拿到本地hash和登录用户凭据横向移动:利用BloodHound找到的路径,用拿到的凭据在其他机器横向权限提升:通过ACL滥用、委派攻击、组添加等方式提升权限重复循环:每拿到新机器就重复上面步骤,直到拿到域管DeathStar所采用的攻击方式,是借助错误的配置以及以低概率使得系统处于不稳定的状态。它默认并不会去运用比如MS17-010这类有可能让系统出现问题的漏洞。安装使用前置要求需要先部署好 https://github.com/BC-SECURITY/Empire,并且启动REST API:# 启动`Empire` `REST API` Python `Empire --rest` --username Empireadmin --password Password123!安装方式一:Docker(推荐)Docker run --rm -it byt3bl33d3r/`deathstar -u` empireadmin -p Password123! --api-host <empire_ip>通过借助 Docker Compose 这个工具,能够同时将 Empire 和 DeathStar 予以启动。具体来讲便是运用 Docker Compose 这个器具,使得 Empire 和 DeathStar 这两个应用可以一同被启动起来。安装方式二:pipxPython3 -m pip install --user `pipx` `pipx` install deathstar-empire安装方式三:源码安装(开发用)需要Python 3.8+和Poetry:git clone https://github.com/byt3bl33d3r/DeathStar && cd DeathStar poetry install poetry run `deathstar -u` empireadmin -p Password123!基础使用启动Empire REST API:Python `empire --rest` --username <username> --password <password>启动DeathStar:`deathstar -u` <empire_username> -p <empire_password> --api-host <empire_ip>要去获取起始的Agent。在任何领域的机器之上获取一个Empire agent,不管权限的大小情况,普通用户权限那也是可以的。当DeathStar察觉到了这个agent的时候,它就自行启动起来开始攻击的流程。非常轻松,余下的全部都交由机器自身去进行操作,一直到获取到域管相关的具体情形。# 常用参数 --debug # 启用调试输出,看详细过程 --api-host # Empire API地址,默认127.0.0.1插件扩展DeathStar的Kyber Crystal插件体系可以使得功能得以扩展。每一个插件是一个Python文件,此文件被放置在deathstar/crystals/这个目录之中。在该文件里面去定义一个crystallize异步函数,便能够对Empire模块进行封装。比如一个简单的枚举域控的插件:from deathstar.utils import posh_object_parser, beautify_json async def crystallize(agent): output = await agent.execute( "powershell/situational_awareness/network/powerview/get_domain_controller" ) parsed_obj = posh_object_parser(output["results"]) return parsed_obj你可以依靠你自己来进行插件的编写,进而添加新的TTP以及后渗透方面的模块。防御建议作者也给出了检测和防御建议:DeathStar只是自动化Empire,检测DeathStar就是检测Empire和攻击行为:EDR+AMSI:部署有AMSI集成的EDR产品PowerShell日志:启用ScriptBlock、Module、Transcription级别的PowerShell日志Constrained Language Mode:启用PowerShell约束语言模式LAPS:LAPS随机化本地管理员密码清理危险ACL:用BloodHound定期扫描并修复域内错误配置关键之所在为:__DeathStar在默认状况之下是不会开启任何AMSI绕过或者日志绕过的情形的__。要是使用的人不晓得去做隐蔽的处理,那么在Win10以及更高版本系统的默认配置之下就极容易被EDR给侦测到。优缺点优点缺点全自动域提权,拿到第一个点后不用操作依赖Empire C2框架,部署比较麻烦异步速度快,多域林支持默认不做免杀,容易被EDR检测插件架构,可扩展性好仅支持Empire,不支持Covenant、Sliver等其他C2byt3bl33d3r出品,质量有保障自动化流程容易产生日志和告警,不适合隐蔽红队利用常见配置错误,不打漏洞不搞崩系统需要理解域攻击才能排错项目未来作者表示DeathStar未来有朝着紫队工具方向进行发展的可能性。它既可以用于实施攻击行为,同时还能够对域内的脆弱路径进行检测,并且能够协助蓝队进行加固操作。未来的规划是支持YAML Playbook自定义攻击链,不需要对代码进行修改就能够选择想要使用的TTP。法律声明DeathStar是一种渗透测试工具,它仅仅能够在有授权的红队演练以及安全评估这类情形之下加以运用。要是没有经过许可就去攻击他人的系统,那可是违法的。项目地址:https://github.com/byt3bl33d3r/DeathStar
-
bloodyAD:域渗透 AD LDAP权限提升工具 项目地址:https://github.com/CravateRouge/bloodyAD开发语言:PythonStar:~2.8kbloodyAD是一款Active Directory权限提升的自动化工具。在2024到2025年这个时间段里,它属于AD方向增长比较快速的工具其中的一个。和众多需要在目标处运行二进制文件来进行提权的提权 工具不一样,bloodyAD是借助直接向域控发送LDAP请求来达成AD权限提升的。它不需要往目标机器当中上传任何的文件,只要拥有普通域用户的凭据就可以开展工作。核心特性多种认证方式支持:明文密码、Pass-the-Hash、Pass-the-Ticket、证书认证支持不使用LDAPS的敏感信息交换透明支持SOCKS代理,可以通过CS/Socks代理直接打域控基于skelsec的MSLDAP库,LDAP通信稳定自动利用常见AD ACL配置错误提权支持的攻击工具自动覆盖了大部分常见的AD LDAP提权路径:ACL滥用的状况包含:将DCSync权限赋予给用户、对其他用户的密码进行更改、把用户添加到具有高权限的组之中。从基于资源的约束委派的角度来讲,那便是所谓的RBCD提权情况 。AddKeyCredentialLink(暗影凭据)这类攻击手段,是通过添加密钥暗影凭据以此来获取用户的TGT 。针对DNS记录开展修改操作,并且与AD CS攻击进行相互配合。通过将权限自动提升到域管的路径去进行查找,然后再和配套的自动攻击工具autobloody相互结合,就可以达成从普通用户全自动地攻击到域管这样的状况。使用示例最基础的用法,拿到普通用户哈希后重置域管密码:bloodyAD --host 172.16.1.15 -d bloody.local -u jane.doe -p :70016778cb0524c799ac25b439bd6a31 set password john.doe 'Password123!'给当前用户添加DCSync权限:bloodyAD --host dc01.bloody.local -d bloody.local -u john.doe -p Password123! add dcsyncShadow Credentials攻击给域管添加密钥:bloodyAD --host dc01.bloody.local -d bloody.local -u john.doe -p Password123! add shadowCredentials administrator特点不需要在目标上落地任何文件,纯LDAP协议攻击,隐蔽性高支持代理,可以在内网代理环境下直接使用跨平台,Windows/Linux/macOS都能跑配套autobloody工具可以自动寻找从当前用户到域管的提权路径并自动执行比手动跑PowerView命令效率高很多,__但LDAP协议攻击对日志敏感,需注意域控审计策略__,减少手动操作出错项目Wiki具备着十分周全的使用文档以及针对攻击场景的说明内容,对于去开展AD渗透而言,是很有值得去获取的物件。
-
AutoCVE-一周30个CVE:这个Agent把CVE挖掘全流程自动化了 依靠手工去寻找CVE到底会有多么的困难?很多曾经有过相关经历去做过这件事的人内心之中都是非常清楚的很。筛选项目,寻觅开源仓库,对环境进行配置来运行SAST,手动去过滤很多误报情况,从Sink往回追溯SouRCE来分析数据流,撰写PoC来进行验证,整理英文方面的报告……这样一套流程走下来,短的时候是几天长的时候是几周,大部分的时间都花费在重复的劳动上面,留给思考的时间没有多少。最近我瞧见有一个刚刚发布出来的开源项目叫做 AutoCVE。该项目的作者,把CVE挖掘的那一系列的流程都交托给Agent去自动化地进行操作。这流程包含了选项目、导仓库、审代码、验漏洞、写报告这类步骤。这并非是 PPT 形式的项目。官方进行的测试是一周时间,并且是全自动运行的,获取到了 30 个 CVE 编号,还涉及 14 个开源项目。最高的 CVSS 评分达到了 9.9 ,整个过程可是完全没有人工干预的。在发布两周之后,GitHub 上的星数就突破了 1000 。它到底做了什么?AutoCVE并非是那种将代码随便扔给大模型进行胡乱聊天的套壳类型的项目。它是专门为CVE挖掘场景所设计的 Multi-Agent 审计平台。它具备完整的产品界面、工作流编排、沙箱隔离、工具权限控制这些东西。它进行了好多工程上面的优化,来解决LLM审计发散、不收敛、乱报漏洞这类的问题。整个流程是处于全自动化的状态。从项目的筛选起始,随后是仓库的导入,之后开展创建审计任务的操作,再之后实施Agent漏洞挖掘的行为,最终生成CVE申报报告。用户将报告的内容进行复制下来之后提交上去,便可以完成后续的CVE申请事宜。自动进行筛选项目的操作。你仅仅需要告知它需要挖掘多少个CVE,它自身就会从GitHub上面去寻找适合进行审计的开源项目。自动地将代码导入到仓库之中,接着自动地把代码拉取到本地的工作区域当中。依据项目的规模情况以及相应的配置状况去进行审计模式的选取,随后自动地开展审计任务的创建。存在着 5个专职的Agent 来开展多Agent协同审计工作,此5个Agent分别有着不一样的分工情况,并且各自去履行其自身所承担的职责。于沙箱之内运行PoC以动态验证漏洞,与此同时将误报状况予以过滤掉。自动地生成那CVE的报告,输出那种符合CVE申报格式的报告,能够进行复制粘贴然后提交。用户首先需要将模型进行配置操作完毕,随后便等待模型运行结束,紧接着把报告进行复制的动作完成,之后进行CVE的提交操作,这样就视为完成了相关的一系列流程。5个Agent怎么分工?通过Orchestrator统一调度Recon、Scan、Triage、Finding和Verification等Agent,协同完成信息收集、工具扫描、误报过滤、漏洞深挖与动态验证:整个工作流由Orchestrator统一调度,每个Agent只干自己擅长的事:Recon(侦察):分析项目情况——什么语言、什么框架、入口文件在哪、哪些路径优先审计Scan(扫描):调用Semgrep、Bandit这些现成SAST工具先跑一轮规则扫描Triage(分诊):对Scan出来的结果做人工复核,把明显误报过滤掉,补充证据Finding(挖掘):核心审计Agent,通过源码追数据流,构造攻击链,挖高价值0dayVerification(验证):在Docker沙箱里动态运行PoC,验证漏洞是否真的能打,不靠猜AutoCVE当前支持 三种审计模式,可根据不同的审计目标选择:交互式审计与全过程追踪AutoCVE拥有着完备的交互能力。那完整的审计过程会被视作会话的上下文。用户可以围绕着审计的结果继续进行追问,让Agent去补充证据、去解释攻击链、去完善复现的步骤又或者是去扩展漏洞的分析 。可以展开查看每个工具调用的详细信息:输入$便可以显示出来并且调用相应的Skill。要是没有指定模型的话,系统会根据任务自动去匹配合适的Skill 。可视化审计追踪模块集中展示活动日志、Agent Tree、工具调用、阶段进度、初步报告和审计会话,方便复盘每次审计的执行路径与关键过程:智能化漏洞管理审计发现的漏洞由Agent调用工具自动提交,经过去重后以结构化形式入库,并在漏洞管理模块中统一维护:AutoCVE的漏洞报告会由Agent自动结构化生成,包含Summary、DetAIls、PoC、Impact、Remediation、Disclosure Notes、Affected products、CVSS、CWE、Suggested CVE description等字段,可复制用于从GitHub Advisory提交漏洞报告:还支持根据实际需求为不同Agent配置专属Skills,灵活扩展各Agent的能力边界:实际成果:一周30个CVE说再多不如看战果。官方一周测试,全自动跑下来共拿到 30个CVE,覆盖的都是真实有用户量的开源项目,不是靶场。CVE编号项目漏洞类型CVSSCVE-2026-48765typebot.io授权绕过9.9CVE-2026-43986TautulliSSRF9.9CVE-2026-43984Tautulli存储型XSS8.9CVE-2026-43985TautulliCSRF8.8CVE-2026-41235froxlor授权错误8.8CVE-2026-46372SillyTavernSSRF8.5CVE-2026-48763typebot.io权限缺失8.2CVE-2026-48764typebot.ioSSRF8.2CVE-2026-40904Chartbrew越权访问8.1CVE-2026-40600Chartbrew越权访问8.1CVE-2026-45260pimcore权限缺失8.1...还有19个SQL注入/RCE/硬编码密钥等3.7-8.1涉及的项目包含 xxl-job、JeecgBoot、o2oa、Lemmy、Chartbrew、BentoML、typebot.io、OpenReplay、SillyTavern、pimcore、froxlor、Tautulli、filebrowser、craftcms —— 14个项目,其中不少是数万Star的热门项目。部署和使用部署非常简单,一行Docker命令搞定,不需要自己搭环境:# Linux/macOS/Git Bash curl -fsSL https://raw.githubusercontent.com/larlarua/AutoCVE/v1.0.5/docker-compose.prod.yml | Docker compose -f - up -dWindows PowerShell/CMD也一样:curl.exe -fsSL https://raw.githubusercontent.com/larlarua/AutoCVE/v1.0.5/docker-compose.prod.yml | Docker compose -f - up -d启动完访问:前端界面:http://localhost:3000API文档:http://localhost:8000/docs流程实际上是挺简单的。首要的是配置你那个 LLM API Key ,它能够支持比如 OpenAI、DeepSeek 等各式各样的模型。随后可以挑选导入项目,或者开启一键 CVE 这个功能。紧接着就是等着 Agent 把流程给跑完。再之后到漏洞管理那边去查看相应的结果。最后导出报告并且提交 CVE 。一点感受AI代码审计并非是什么全新的事物。以往存在着不少类似的项目。但是大多数要么仅仅处于demo的水平,拿不上台面,要么就是弄一个空壳子来调用API,要是真的想要挖掘漏洞还是得依靠人去进行操作。AutoCVE比较难得的地方在于它是真真正正从产出CVE这个目标往回倒推来进行工程化打造的产品,并非是为了展示AI而去弄AI。多Agent分工、Triage过滤误报、Verification沙箱验证、Nudge纠偏、结构化输出这些细节方面,是实际运用LLM去审计代码的时候会碰到的坑,作者都想到了而且还给出了解决的办法。30个真实CVE的战果便是最好的证明——这玩意儿确实能挖出漏洞来。它并非是用来取代安全研究员的。恰恰相反——它将人从筛项目、跑工具、写报告这类重复劳动中解放出来,让人把精力投放到真正需要思考的复杂漏洞逻辑上去。对于很多想要去挖掘CVE但是效率比较低的人,又或者企业里很多要进行批量审计开源组件的团队而言,这个工具是值得去尝试一下的。项目地址GitHub:https://github.com/larlarua/AutoCVE项目才刚刚推出了v1.0.5版本,还在不断地快速进行更新迭代。要是你对它感兴趣的话,那就可以到上面去点一个Star、提出一个Issue相关的,或者自己把它运行起来,去尝试着找找CVE 。⚠️ 重要提醒:工具仅可用于授权安全研究,绝对禁止在未授权情况下扫描他人系统。提交漏洞时请遵循负责任披露规范。服务器推荐